1つのAIで、現場の「聞きたい音」だけを取り出す技術
タスク汎用音源分離技術「TUSS」
概要
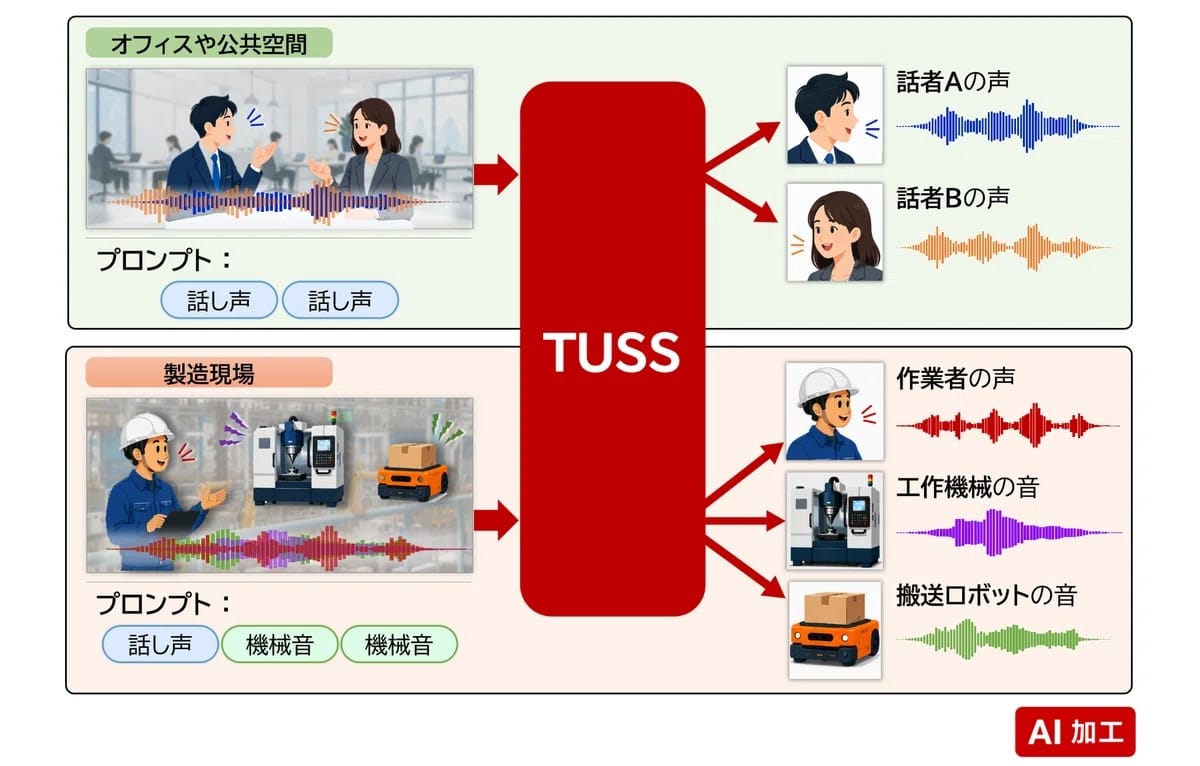
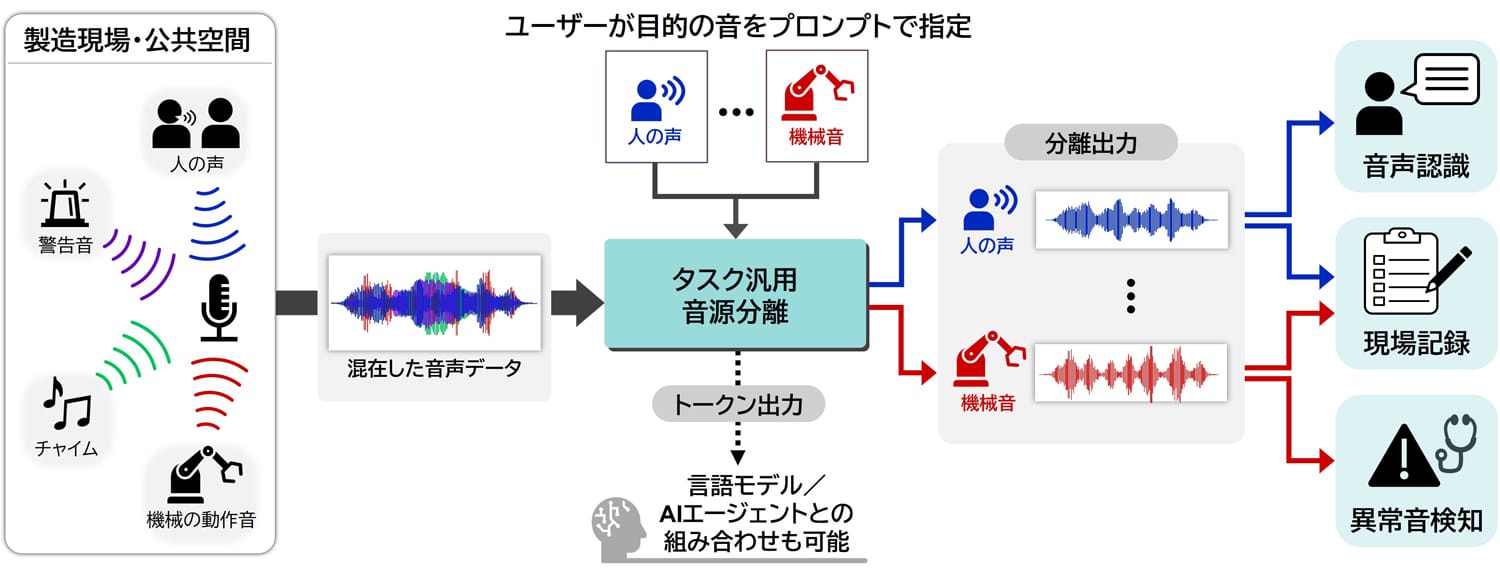
「タスク汎用音源分離技術(TUSS:Task-aware Unified Source Separation)」は、複数の音が混在する環境下で、取り出したい音の種類をプロンプトで指示するだけで目的の音を自在に分離・抽出できるAI技術だ。三菱電機株式会社と米国研究所Mitsubishi Electric Research Laboratories(MERL)が共同開発し、2026年8月に発表。「CEATEC 2026」において最優秀賞に相当する「CEATEC AWARD 2026 総務大臣賞」を受賞した。
従来は「人の声用」「特定機械音用」などタスクごとに専用AIを構築・運用する必要があったのに対し、TUSSは複数話者分離、音声強調、環境音抽出を単一のAIモデルで完結。マイク本数に依存しない柔軟なアーキテクチャを持ち、画像や映像が中心だったフィジカルAIや産業ロボットに高精度な「聴覚」を付与する基盤技術として期待されている。
なにがすごいのか?
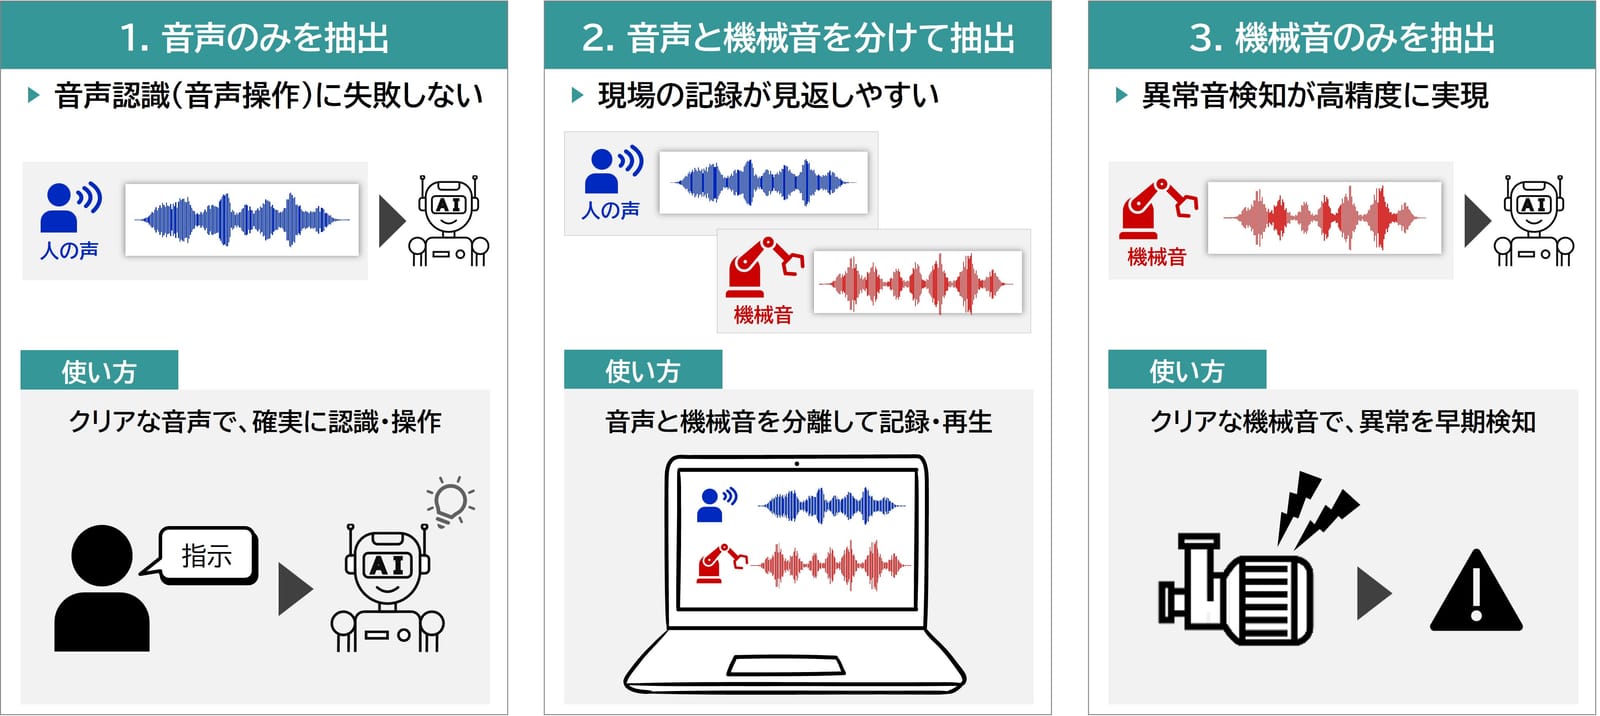
取り出したい音をプロンプトで指定するだけで、人の声・機械音・特定ノイズを瞬時に選別。プロンプト指定で多様な分離タスクを「単一AIモデル」で完結する。
現場や目的が変わっても、音の種類ごとに専用のAIを作り直さずに対応できる
マイクの本数に依存せず、単一マイク(モノラル)でも機能する設計のため、ロボットや監視機器など多様な機器に実装でき、フィジカルAIに聴覚情報を加えられる
なぜ生まれたのか?
製造プラントや公共インフラの現場では、大型機器の稼働音、作業員の指示、突発的な環境音が複雑に重なり合う。音は光や映像のように遮蔽物で区切ることができず、AIが現場の状況を正確に把握する上で「音の混濁」が致命的なボトルネックとなっていた。
三菱電機とMERLは、2016年のブレークスルー以来、人の声を分離するサービス「waketekoo」の実用化などを通じて音源分離技術を蓄積してきた。しかし現場からは「この特定ポンプの異音だけを拾いたい」「騒音下での作業指示音声だけをクリアにしたい」といった、状況に応じて変化する個別具体的な要望が相次いだ。
分離対象ごとに専用AIを学習・保守する従来アプローチでは、多品種少量生産の工場や変化の激しい現場に対応しきれない。そこで、2024年に開発した時空間音響モデルを礎に、「プロンプトで振る舞いを切り替える基盤モデル」という発想へと舵を切り、TUSSの実現に至った。
なぜできるのか?
取り出したい音を「プロンプト」で指定し、1つのモデルの振る舞いを切り替える
ネットワーク内部に学習可能な音源指定プロンプトを組み込み、プロンプトの差し替えのみでモデルの抽出挙動を動的に制御する。 分離したい音の数(N個)に応じたプロンプトを入力することで、単一モデルでありながら複数話者分離・特定楽器抽出・ノイズ除去といった構造的に異なる分離処理を同一の重みパラメータで実行できる。
時間と周波数の両方を捉える「TF-Locoformer」が支える分離性能
MERLが開発した音響トランスフォーマーモデル「TF-Locoformer」をバックボーンに採用。 局所的な畳み込み処理と大域的なアテンション機構を組み合わせ、時間軸と周波数軸の双方から音の微細な特徴量を抽出。「クロスプロンプトモジュール」でプロンプトと音響特徴を相互参照させ、「条件付き目的音抽出モジュール」によって目的の波形を高精度に復元する。
現場への実装を見据えた、処理の高速化とマイク本数に依存しない設計
音響の位相情報や空間配置に過度に依存せず、波形そのものの音響特性を捉えるため、特殊なマルチマイクアレイを組まずとも単一マイク入力から分離が可能。 さらに、演算量を73〜81%削減しながら性能劣化を0.4〜1.2dBに抑えた高速版「FasTUSS」を確立しており、工場内センサー端末や現場作業端末、自律移動ロボットのオンボード処理への組込適性を担保している。
相性のいい産業分野
この知財の情報・出典
この知財は様々な特許や要素技術が関連しています。 詳細な情報をお求めの場合は、お問い合わせください。 Top Image : © 三菱電機 株式会社